KMeans聚类
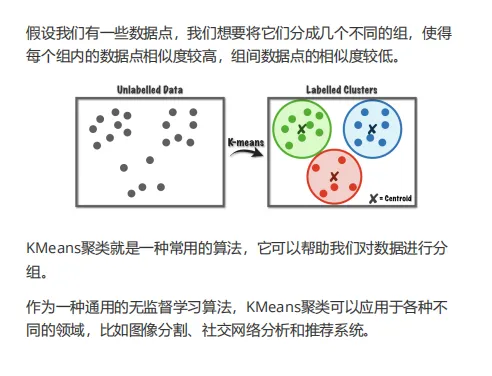
一句话解释:K-Means 就是让计算机把一堆没有分类的数据,按照相似程度,自动分成 K 个组
假设我们有 12 个学生,要把他们分成 3 组,也就是 K = 3。
整个过程可以理解为 4 步:
- 随机选 3 个中心点:相当于先在操场上安排 3 个组长。
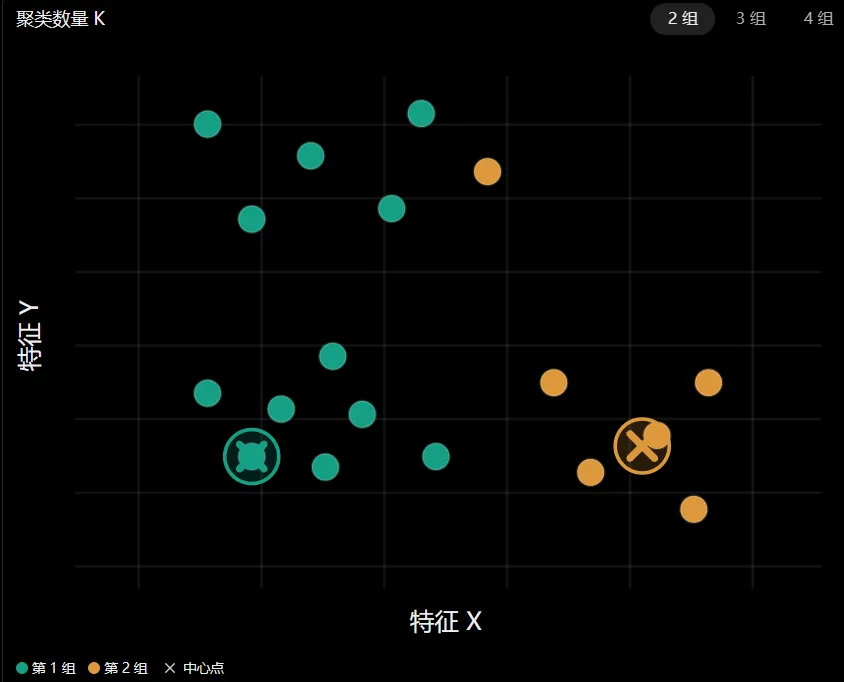
- 学生寻找最近的组长:每个人加入离自己最近的组。
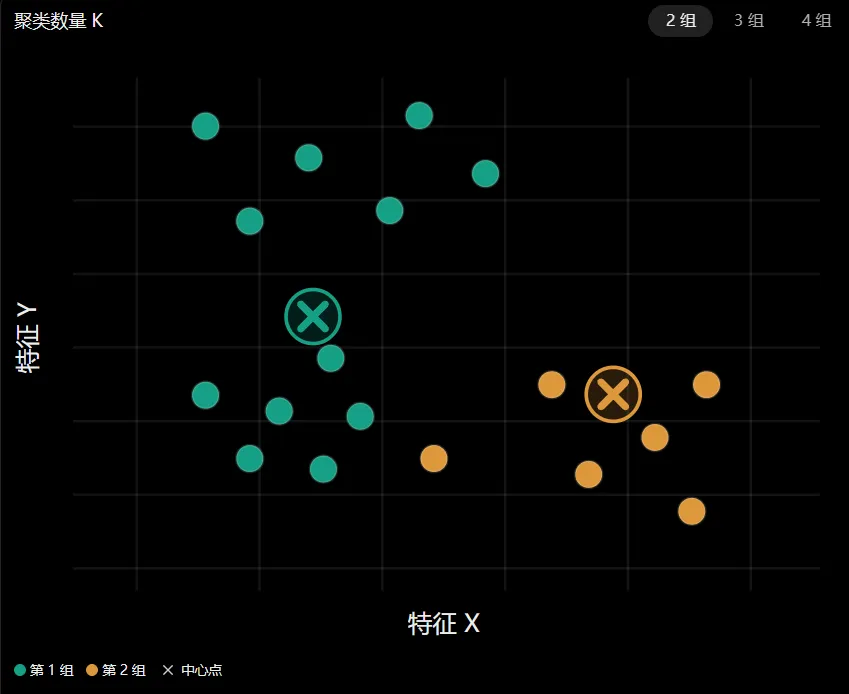
- 重新选组长的位置:根据每组所有人的位置,计算平均位置,作为新的中心点。
- 重复第 2、3 步:直到分组基本不再变化。
这里的 Means 就是“均值”的意思,因为每次都会根据组内数据的平均值更新中心。
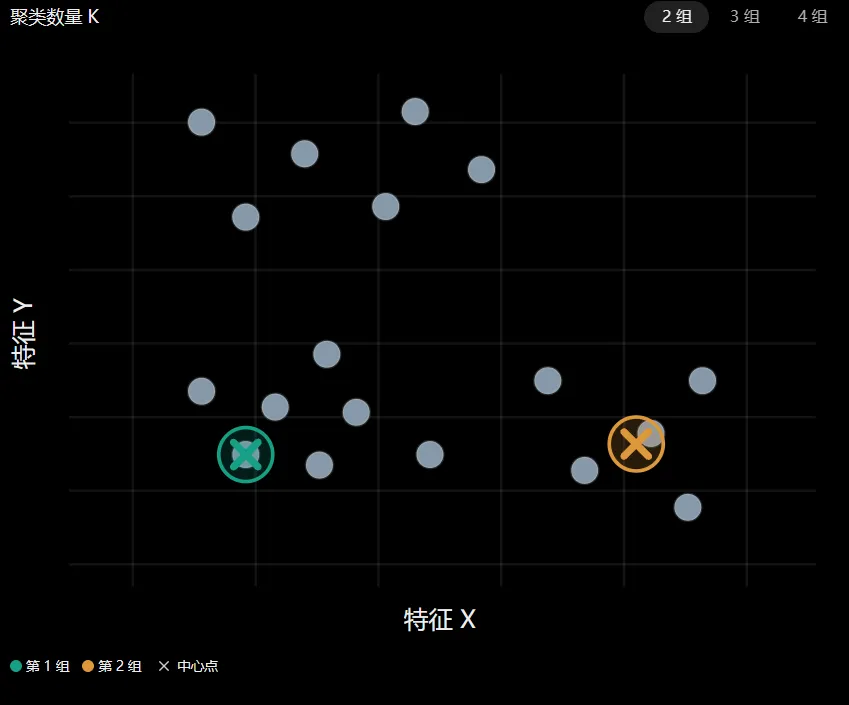
每个数据点寻找最近的中心,颜色表示它加入的组
计算各组数据点的平均位置,将中心移动到新的位置
K-Means 属于无监督学习(Unsupervised Learning)
因为你不需要提前告诉计算机每条数据属于什么类别,它会自己寻找数据之间的相似性
K 值需要事先指定:比如究竟分成 3 组还是 5 组,需要自己选择。
容易受初始中心影响:不同的初始位置,有可能导致不同的分组结果。实际常用 K-Means++ 来改善初始化。
对异常值比较敏感:比如一个身高 3 米的数据,就可能把某一组的中心拉偏。
对数据尺度敏感:身高和收入放在一起计算距离时,数值尺度较大的特征可能主导结果,因此通常要先标准化